ElevenLabs hat am 20. Oktober 2026 Eleven Realtime vorgestellt, eine neue Klasse von Speech-to-Speech-Modellen für Sprachagenten. Statt Spracherkennung, Sprecherwechsel, Sprachmodell und Sprachausgabe einzeln zusammenzubauen, wählen Unternehmen nur noch ein Modell aus. Ich habe die Angaben mit der offiziellen Dokumentation und unabhängigen Berichten abgeglichen.
Das Wichtigste in Kürze:
- Zwei Modelle: Eleven Realtime v1 Mini für schnelle, günstige Gespräche und v1 Max für komplexe Aufgaben mit Tool-Aufrufen.
- Tempo: v1 Max beginnt laut ElevenLabs im Schnitt nach 0,57 Sekunden zu sprechen, v1 Mini nach 0,62 Sekunden.
- Genauigkeit: v1 Max beantwortet im Benchmark Big Bench Audio 98,8 Prozent der 1.000 gesprochenen Logikfragen richtig, v1 Mini 75,9 Prozent.
- Einstieg: Nutzbar über die Plattform ElevenAgents oder über eine Realtime API, die das Protokoll der OpenAI Realtime API spricht.
Was ist Eleven Realtime?
Eleven Realtime ist ein kompletter Sprachagent in einer einzigen Modellauswahl. Jedes Modell bündelt Spracherkennung (ASR), Sprachaktivitätserkennung und Turn-Taking, ein Sprachmodell (LLM) und Sprachausgabe (TTS). ElevenLabs hat diese Bausteine ausgewählt und so abgestimmt, dass sie als ein System arbeiten. Bisher mussten Entwickler jede Komponente selbst wählen und mühsam aufeinander einstellen.
Kaskadiert, nicht verschmolzen
Obwohl ElevenLabs von Speech-to-Speech spricht, ist Eleven Realtime kein „fused“ Modell, das Audio direkt in Audio umwandelt. Laut Dokumentation nutzen beide Varianten eine kaskadierte Architektur: Jede Komponente ist ein eigenes Modell, Ende-zu-Ende auf das Zusammenspiel optimiert. Welche Einzelmodelle genau dahinterstecken, legt ElevenLabs nicht offen.
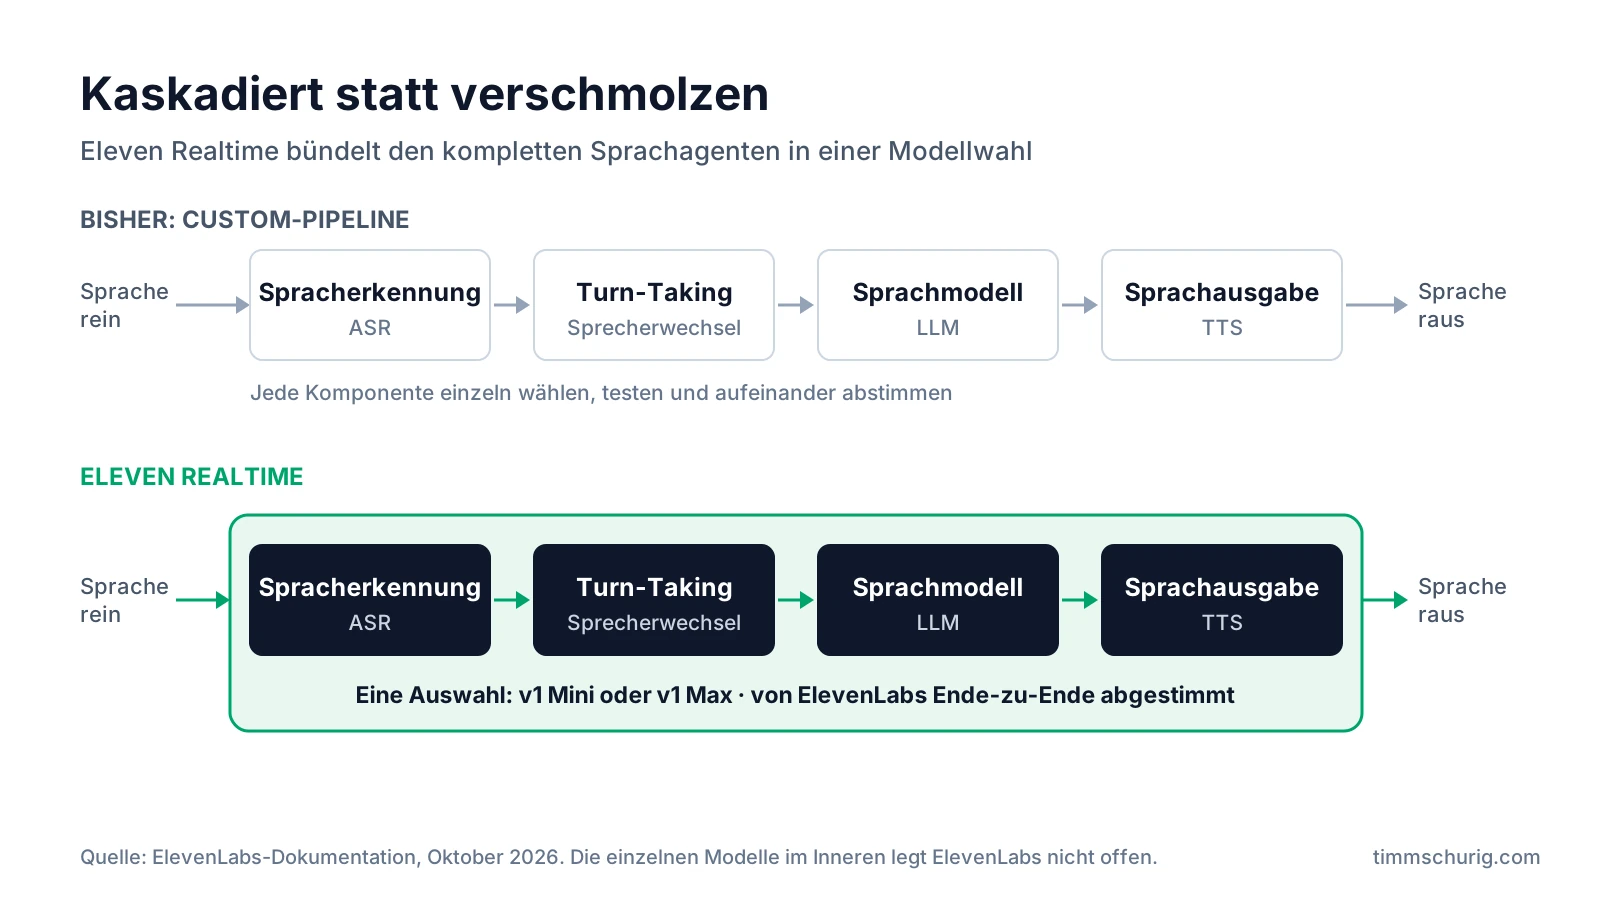
Der Vorteil dieser Bauweise: Beide Modelle unterstützen mehr als 90 Sprachen und können jede der über 17.000 Stimmen aus der ElevenLabs-Bibliothek nutzen. Der Nachteil laut The New Stack: Entwickler können die darunterliegenden Modelle nicht selbst auswählen oder einzeln konfigurieren.
Natürliche Gesprächsführung
Das Modell erkennt selbst, wann jemand ausgeredet hat, und reagiert auf Unterbrechungen. Im Benchmark Full-Duplex-Bench geht es genau darum: Pausen, Sprecherwechsel, Unterbrechungen und kurze Rückmeldungen wie „mhm“. Über die Realtime API lässt sich dafür eine semantische Sprecherwechsel-Erkennung (semantic VAD) mit einstellbarer Reaktionsfreude konfigurieren.
v1 Mini vs. v1 Max im Vergleich
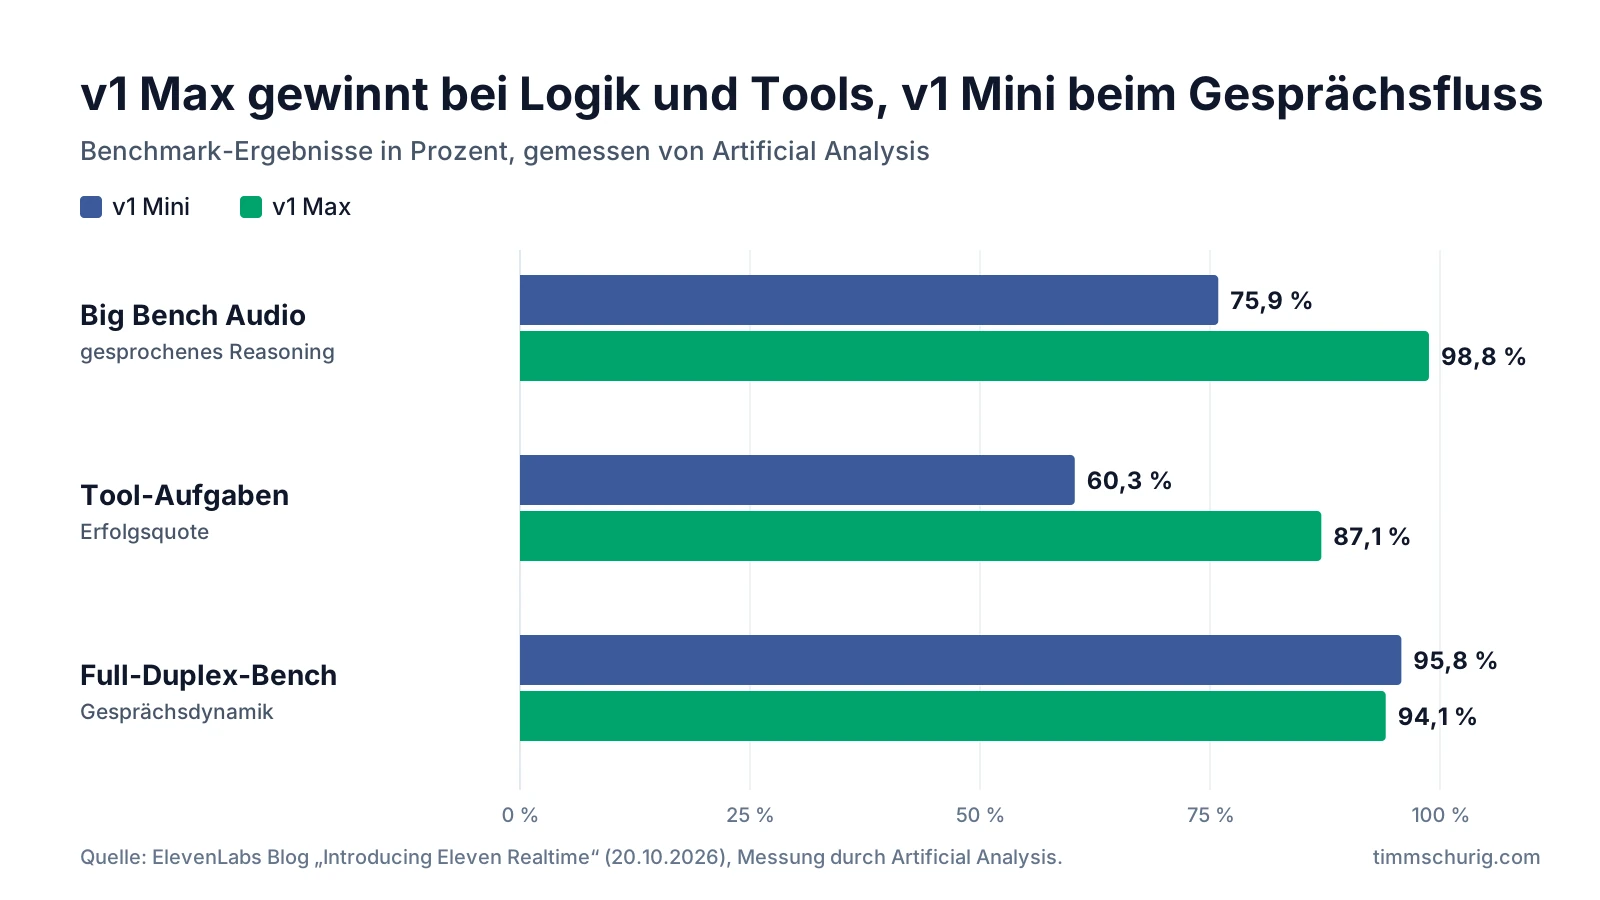
v1 Max ist das stärkere Modell für Aufgaben mit Logik und Tools, v1 Mini das günstigere für flüssige Gespräche. Die Benchmarks hat Artificial Analysis unabhängig erhoben, veröffentlicht wurden sie von ElevenLabs.
| Merkmal | Eleven Realtime v1 Mini | Eleven Realtime v1 Max |
|---|---|---|
| Model-ID | eleven_realtime_v1_mini | eleven_realtime_v1_max |
| Einsatz laut ElevenLabs | KI-Assistenten, Tutoren, interaktive Figuren | Kundensupport, Lead-Qualifizierung, mehrstufige Abläufe mit Tools |
| Zeit bis zum ersten Audio (Ø) | 0,62 s | 0,57 s |
| Big Bench Audio (gesprochenes Reasoning) | 75,9 % | 98,8 % |
| Full-Duplex-Bench (Gesprächsdynamik) | 95,8 % | 94,1 % |
| Erfolgsquote bei Tool-Aufgaben | 60,3 % | 87,1 % |
| Speech Agent Arena (Blindvergleich) | 988 | 998 |
| Kosten pro Token | niedriger | höher |
Was die Zahlen bedeuten
v1 Max ist schneller als v1 Mini. Ungewöhnlich, aber laut ElevenLabs so gemessen: Das größere Modell antwortet im Schnitt 50 Millisekunden früher. Die Zeit wurde als Durchschnitt über den Big-Bench-Audio-Test ermittelt.
v1 Mini gewinnt nur beim Gesprächsfluss. Im Full-Duplex-Bench liegt Mini knapp vorne. Bei Logik und Tool-Aufrufen ist der Abstand groß: 27 Prozentpunkte bei den Tool-Aufgaben. ElevenLabs empfiehlt Max deshalb ausdrücklich für Agenten mit vielen Tool-Aufrufen.
Einordnung im Wettbewerb: Laut ElevenLabs ist auf dem Leaderboard von Artificial Analysis kein Modell zugleich schneller und genauer als v1 Max. Zum Vergleich: Grok Voice 3.0 von xAI führt den Speech-to-Speech-Index von Artificial Analysis an, kommt bei Big Bench Audio auf 98,5 Prozent und braucht 0,81 Sekunden bis zum ersten Audio. Der Benchmark ist mit Werten um 98 bis 99 Prozent allerdings nahezu ausgereizt.
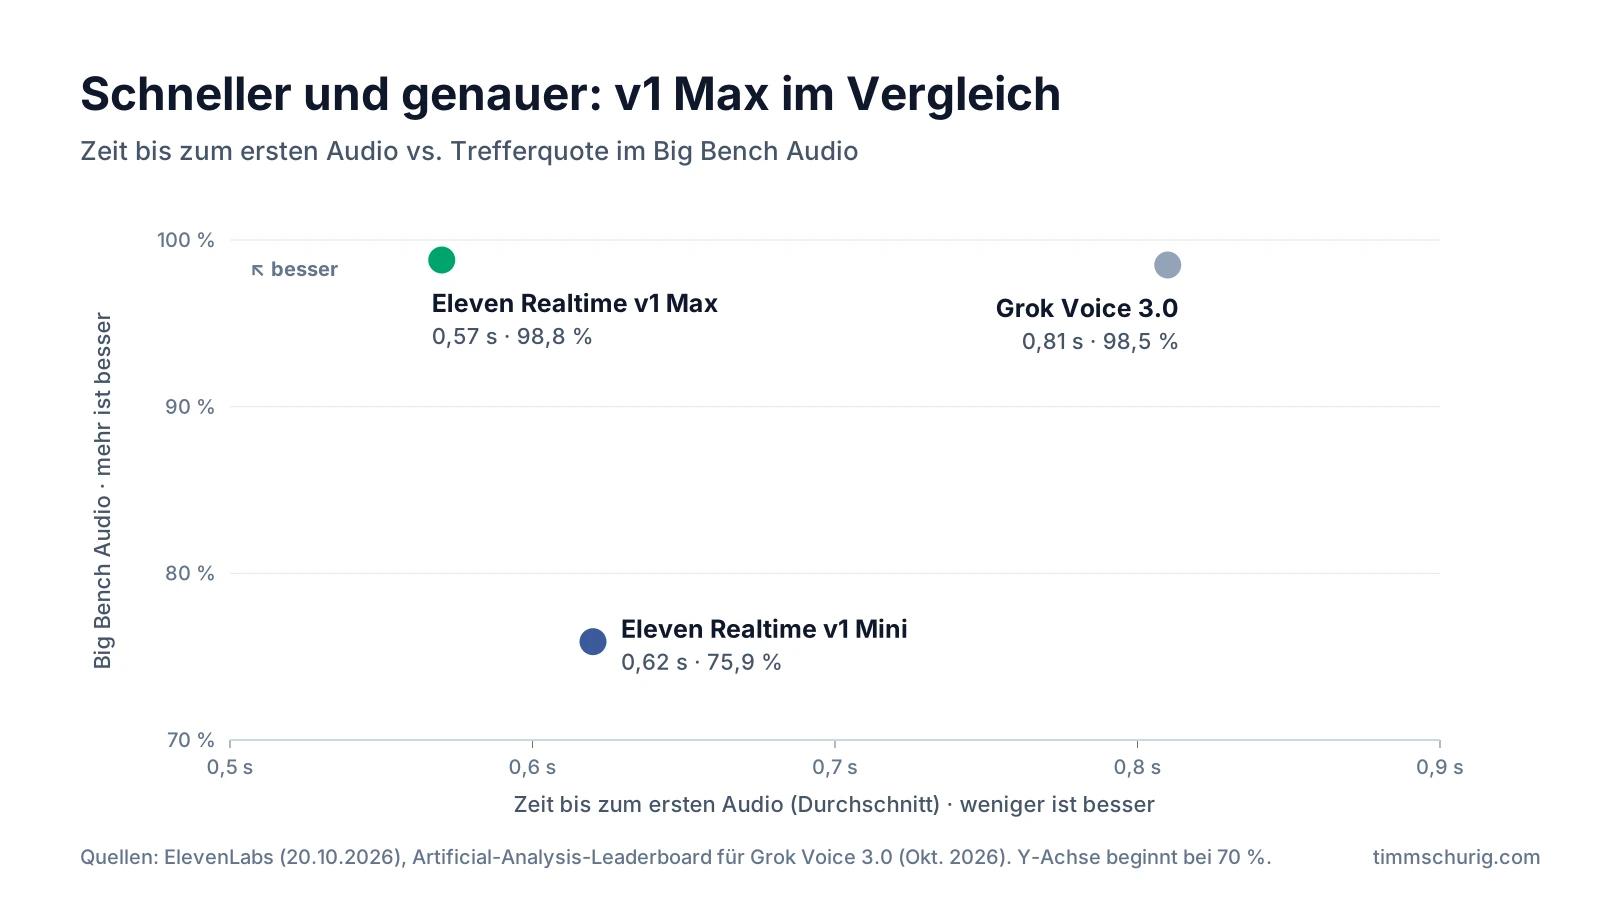
Wichtig: Alle Werte stammen aus Testumgebungen. Wie sich Eleven Realtime unter echter Last im Kundenbetrieb schlägt, zeigen die Benchmarks nicht.
Zwei Wege zur Integration
Eleven Realtime lässt sich über die Agenten-Plattform ElevenAgents oder direkt über die Realtime API nutzen. ElevenLabs empfiehlt ElevenAgents für den produktiven Einsatz.
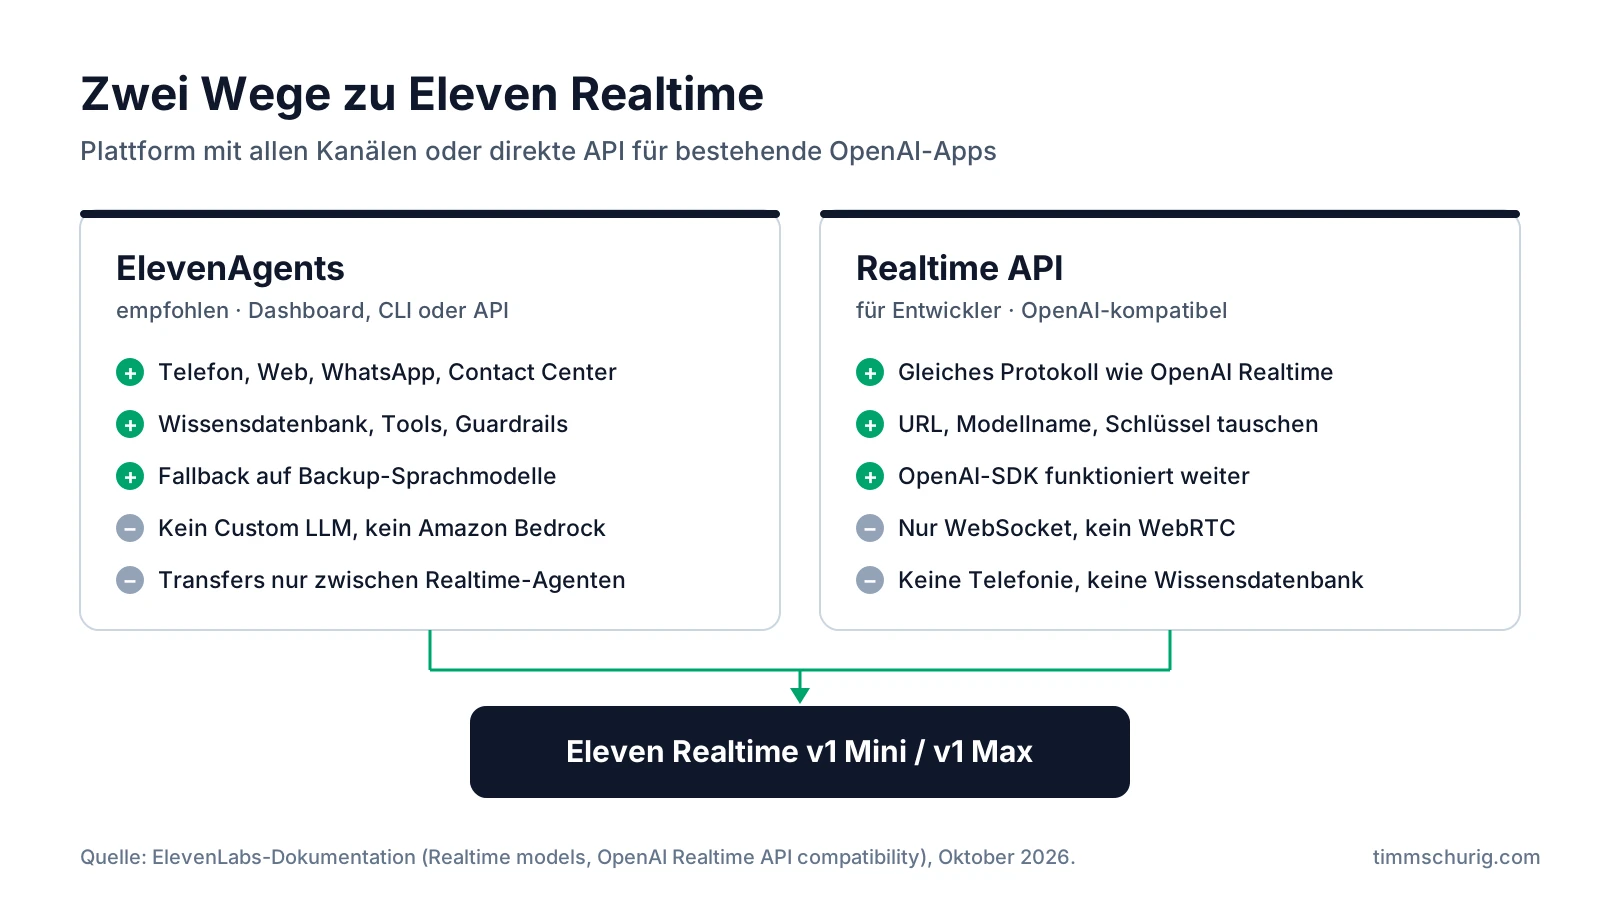
Weg 1: ElevenAgents
Jeder Agent hat einen „Voice mode“: Custom oder Realtime. Im Custom-Modus wählt man Sprachmodell, Stimmmodell und Spracherkennung selbst. Im Realtime-Modus wählt man v1 Mini oder v1 Max, den Rest verwaltet ElevenLabs.
Was ElevenLabs übernimmt: Sprachmodell, Reasoning-Einstellungen, parallele Tool-Aufrufe, Stimmmodell und Spracherkennung.
Was weiter einstellbar bleibt: System-Prompt, erste Nachricht, Stimme, Sprachen, Temperatur, Tools, Wissensdatenbank sowie Gesprächsflusseinstellungen wie Reaktionsfreude, Timeouts und Unterbrechungen. Die Temperatur ist im Realtime-Modus allerdings nur noch über CLI oder API änderbar.
Kanäle: Telefon, Web, WhatsApp und Contact-Center-Systeme (CCaaS), dazu Workflows, Guardrails, Tests und Monitoring.
Einschränkungen:
- Kein Custom LLM und kein Amazon Bedrock im Realtime-Modus.
- Workflow-Knoten dürfen die verwalteten Einstellungen nicht überschreiben.
- Weiterleitungen (Agent Transfers) funktionieren nur zwischen Realtime-Agenten. Mini zu Max geht, Realtime zu Custom nicht.
- v1 Max braucht ein Token-Limit von mindestens 1.024 oder gar kein Limit.
- Für reine Text-Agenten ist Realtime nicht gedacht.
Antwortet das Realtime-Modell nicht rechtzeitig oder mit einem Fehler, springt das sogenannte LLM Cascading ein und greift auf Backup-Sprachmodelle zurück.
Weg 2: Die Realtime API
Die Realtime API spricht dasselbe Wire-Protokoll wie die OpenAI Realtime API, mit denselben Client- und Server-Events. Wer schon eine App mit dem OpenAI-SDK @openai/agents-realtime gebaut hat, ändert im Kern drei Dinge: die WebSocket-URL (wss://api.elevenlabs.io/v1/convai/realtime), den Modellnamen und die Herkunft des kurzlebigen Zugangsschlüssels, den das eigene Backend bei ElevenLabs anfordert.
Drei Punkte sollte man vor der Migration kennen:
- Nur WebSocket: Bestehende WebRTC-Integrationen müssen zuerst auf WebSocket umgestellt werden. Audio-Aufnahme und Wiedergabe (PCM16, 24 kHz) muss man dann selbst umsetzen.
- Keine Plattformfunktionen: Telefonie-Kanäle, die gehostete Wissensdatenbank und andere ElevenAgents-Features gibt es über die API nicht.
- Doku noch lückenhaft: Beschrieben ist bisher der Weg aus dem Browser. Anleitungen für serverseitige OpenAI-SDKs fehlen noch.
Für KI-Coding-Tools wie Claude Code oder Cursor stellt ElevenLabs außerdem ein Skill-Paket bereit. Der Skill „realtime“ hilft beim Aufsetzen von Realtime-Agenten und bei der Migration einer OpenAI-Realtime-App. Installiert wird die Sammlung mit npx skills add elevenlabs/skills.
Preise, Verfügbarkeit und Datenschutz
Preismodell: In ElevenAgents zahlt man den normalen Minutenpreis der Plattform plus Token-Kosten für Input, gecachten Input und Output. Über die Realtime API zahlt man pro Minute verbundenem Audio plus Tokens, mit gleichen Token-Preisen in allen Tarifen. v1 Max kostet pro Token mehr als v1 Mini. Konkrete Token-Preise hat ElevenLabs zum Start nicht öffentlich genannt, im Modell-Auswahlmenü der App erscheint eine geschätzte Minutenpauschale.
Interessant ist der Hinweis von The New Stack: Weil Max Tool-Aufgaben deutlich zuverlässiger löst, kann es trotz höherem Token-Preis am Ende günstiger sein, wenn Mini mehrere Anläufe braucht.
Verfügbarkeit: Die Realtime API ist dokumentiert und nutzbar. Der Realtime-Schalter in ElevenAgents wird schrittweise für die Workspaces freigeschaltet. Fehlt die Option „Voice mode“ im Agent-Tab, ist der eigene Workspace noch nicht dran.
Datenschutz und Datenstandort:
| Umgebung | v1 Mini | v1 Max |
|---|---|---|
| USA | verfügbar | verfügbar |
| EU-Datenresidenz | verfügbar | verfügbar |
| Indien / Singapur | verfügbar | nicht verfügbar |
| Zero Retention Mode und HIPAA | nicht verfügbar | verfügbar (USA und EU) |
Für Unternehmen in Deutschland heißt das: Beide Modelle laufen mit EU-Datenresidenz. Wer zusätzlich verlangt, dass ElevenLabs keine Gesprächsdaten speichert (Zero Retention Mode), muss v1 Max wählen.
Nicht verwechseln: Drei Produkte mit „Realtime“ im Namen
ElevenLabs nutzt den Begriff Realtime für drei verschiedene Produkte. Nur eines davon ist ein kompletter Sprachagent.
| Produkt | Was es macht | Wichtigste Fakten |
|---|---|---|
| Eleven Realtime (v1 Mini / v1 Max) | Kompletter Sprachagent mit Spracherkennung, Sprachmodell, Turn-Taking, Tools und Sprachausgabe | Start 20.10.2026, 90+ Sprachen |
| Eleven Realtime Translation | Live-Übersetzung von Gesprächen in beide Richtungen, jede Person hört die andere in ihrer Sprache | Ausgabe in 90+ Sprachen mit Eleven v4 Turbo; Parameter „eagerness“ (low, medium, high) regelt Tempo gegen Übersetzungsqualität; derzeit nur für Enterprise-Workspaces |
| Scribe v2 Realtime | Reine Live-Transkription (Speech-to-Text) | Rund 150 ms Latenz, 90+ Sprachen |
Das medizinische Modell Scribe v2 Medical (scribe_v2_medical) ist übrigens eine Variante von Scribe v2 für die Stapelverarbeitung, keine Echtzeit-Variante. Für Live-Transkription verweist ElevenLabs auf Scribe v2 Realtime.
Was bedeutet Eleven Realtime für Unternehmen?
Sprachagenten werden einfacher, schneller und billiger. Damit rücken sie auch für kleinere Unternehmen in Reichweite: als Telefonassistent, der Termine annimmt, als Support-Hotline außerhalb der Geschäftszeiten oder als Agent, der Anfragen vorqualifiziert. Mit v1 Max lassen sich solche Agenten an Kalender, CRM oder Shop anbinden, ohne vorher Spracherkennung, Sprachmodell und Stimme einzeln zu testen.
Für die Sichtbarkeit im Netz ist das ein weiterer Schritt in dieselbe Richtung: Menschen suchen nicht mehr nur per Tastatur, sondern fragen per Stimme. Sprachagenten und Sprachassistenten antworten mit dem, was sie über ein Unternehmen finden. Ob deine Firma dort genannt wird, hängt davon ab, wie gut deine Inhalte für KI-Systeme lesbar und zitierbar sind. Genau darum geht es bei Generative Engine Optimization (GEO). Ob sich der Aufwand für dein Unternehmen schon lohnt, habe ich in meinem Beitrag Lohnt sich GEO? durchgerechnet.
Die Grundlage bleibt trotzdem klassisch: Ein Sprachagent, der Fragen zu deinem Angebot beantwortet, braucht saubere Inhalte, klare Strukturen und eine Website, die Suchmaschinen und KI-Systeme verstehen. Wie stark KI-Agenten schon heute die Arbeitswelt verändern, zeigt übrigens die Anthropic-Studie zu Junior-Jobs und KI-Agenten. Und wer sich für die aktuellen Sprachmodelle hinter solchen Agenten interessiert, findet im Faktencheck zu Gemini 4 Argon einen weiteren Überblick.
Du willst, dass deine Website in Google und in KI-Antworten auftaucht? Als SEO-Freelancer aus Langenfeld kombiniere ich klassische Suchmaschinenoptimierung mit GEO. Schreib mir für ein unverbindliches Erstgespräch.
Häufige Fragen zu Eleven Realtime
Was ist Eleven Realtime? Eleven Realtime ist eine Modellfamilie von ElevenLabs für Sprachagenten, vorgestellt am 20. Oktober 2026. Jedes Modell vereint Spracherkennung, Sprecherwechsel, Sprachmodell und Sprachausgabe in einem abgestimmten System.
Was ist der Unterschied zwischen v1 Mini und v1 Max? v1 Mini ist günstiger und für einfache Gespräche gedacht, etwa KI-Assistenten oder Tutoren. v1 Max ist für komplexe Aufgaben mit Tool-Aufrufen gebaut und erreicht 98,8 Prozent im Benchmark Big Bench Audio, Mini 75,9 Prozent.
Wie schnell antwortet Eleven Realtime? v1 Max beginnt laut ElevenLabs im Schnitt nach 0,57 Sekunden zu sprechen, v1 Mini nach 0,62 Sekunden. Gemessen hat das Artificial Analysis.
Ist Eleven Realtime mit der OpenAI Realtime API kompatibel? Ja. Die Realtime API von ElevenLabs nutzt dasselbe Protokoll und dieselben Events. Bestehende Apps mit dem OpenAI-SDK müssen vor allem Endpunkt, Modellnamen und Zugangsschlüssel ändern, laufen aber nur über WebSocket, nicht über WebRTC.
Unterstützt Eleven Realtime Deutsch? Ja. Beide Modelle unterstützen mehr als 90 Sprachen, darunter Deutsch, und alle über 17.000 Stimmen der ElevenLabs-Bibliothek.
Was kostet Eleven Realtime? Abgerechnet wird ein Minutenpreis plus Token-Kosten. v1 Max ist pro Token teurer als v1 Mini. Konkrete Token-Preise hat ElevenLabs zum Start nicht veröffentlicht.
Ist Eleven Realtime DSGVO-tauglich nutzbar? Beide Modelle sind mit EU-Datenresidenz verfügbar. Zero Retention Mode, also keine Speicherung von Gesprächsdaten bei ElevenLabs, gibt es nur mit v1 Max. Die rechtliche Prüfung für den eigenen Einsatz ersetzt das nicht.